

Determinados em analisar os resultados das pesquisas eleitorais divulgadas este ano para prefeito de Manaus, assessores jurídicos de partidos políticos tem preparado ações cada vez mais detalhadas sobre falhas encontradas na base de dados de levantamentos e identificado falhas graves na condução das pesquisas e nas estimativas das intenções de votos apresentadas à população.
Para embasar tecnicamente as ações e apresentar de forma “esmiuçada” as falhas consideradas “gravíssimas e insanáveis”, o RealTime1 apurou que consultorias estão sendo encomendadas à especialistas de outros estados, que têm se debruçado na análise dos dados fornecidos pelas empresas e apontado inconsistências nos levantamentos.
Uma forma de sustentar de forma incontestável as ações de impugnação e de refutar as acusações das empresas de pesquisa que estão tendo seus resultados suspensos pela Justiça Eleitoral de que existe um “complô” para denegrir a imagem das mesmas.
Em função do embasamento técnico das ações, a Justiça Eleitoral do Amazonas tem concedido o pedido de tutela de urgência, para evitar “o risco de lesão irreparável” da divulgação dos resultados, até que as empresas contraponham os argumentos apresentados.
De acordo com a legislação eleitoral, que regulamenta as pesquisas eleitorais, os partidos políticos, coligações, candidatos e o Ministério Público têm direito ao acesso ao banco de dados das pesquisas eleitorais. Este direito está estipulado no artigo 13 da Resolução nº 23.600/2019, que estabelece:
- Art. 13: Mediante requerimento à Justiça Eleitoral, o Ministério Público, as candidatas e os candidatos, os partidos políticos, as coligações e as federações de partidos poderão ter acesso ao sistema interno de controle, verificação e fiscalização da coleta de dados das entidades e das empresas que divulgarem pesquisas de opinião relativas às candidatas, aos candidatos e às eleições, incluídos os referentes à identificação de entrevistadoras e entrevistadores e, por meio de escolha livre e aleatória de planilhas individuais, mapas ou equivalentes, confrontar e conferir os dados publicados, preservada a identidade das pessoas entrevistadas.
Análises de especialistas embasam as ações
A redação teve acesso à duas dessas análises que deverão servir de base para impugnação da 3ª pesquisa do Ipen (AM-08938) divulgada este ano, e da 1ª pesquisa divulgada pela Action (AM-05195-2024) para prefeito de Manaus e que reproduzimos abaixo.
Em ambas as análises feitas a conclusão é: “os resultados apresentados não podem ser utilizados como estimativas válidas para as intenções de voto em Manaus”.
Entre as incoerências identificadas estão, por exemplo, a “seleção arbitrária de bairros” e até mesmo repetição de entrevistas, “caracterizando a total falta de confiança nos resultados”, segundo as análises realizada.
O que diz a análise da pesquisa divulgada pela Action
A base de dados da pesquisa, que realizou 1.250 entrevistas no período de 17 a 20 de junho, e entregue em formato Microsoft Excel, contém o cabeçalho com os nomes das variáveis, 1.250 linhas e 26 colunas. As variáveis identificadas na base foram, em ordem:
“Harvest ID”; “Finalizada”; “FILTRO I VOTA NA CIDADE”; “FILTRO II IDADE”; “BAIRRO ONDE RESIDE”; “GÊNERO:”; “INT.VOTO P/PREFEITO_ESPONTÂNEA”; “INT.VOTO P/PREFEITO_ESTIMULADA”; “2ºTURNO_CEN 1″; “2ºTURNO_CEN 2″; “2ºTURNO_CEN 3″; “2ºTURNO_CEN 4″; “2ºTURNO_CEN 5″; “2ºTURNO_CEN 6″; “REJEIÇÃO MÚLTIPLA…15″; “REJEIÇÃO MÚLTIPLA…16″; “PRESIDENTE LULA”; “GOVERNADOR WILSON”; “PREFEITO DAVID ALMEIDA”; “NIVEL DE ESCOLARIDADE”; “PRINCIPAL OCUPAÇÃO1″; “RELIGIÃO”; “FAIXA DE RENDA DOMICILIAR”; “FAIXA ETÁRIA”; “ZONA DE MANAUS”; “Data da entrevista”.
”Dados faltantes na pesquisa Action”
As informações listadas abaixo estão ausente na base de dados disponibilizadas e sua inclusão é essencial e indispensável para a análise, validação e credibilidade dos resultados obtidos e apresentados no relatório final da pesquisa:
| Variável | Presente na base? | Observação |
| ID único de entrevista | Sim | |
| ID único de entrevistador | Não | Essencial para checar consistência do campo. |
| ID único de supervisor | Não | Essencial para checar da consistência do campo. |
| ID único de auditor | Não | Essencial para checar da consistência do campo. |
| ID de entrevista auditada | Não | Essencial para checar da consistência do campo. |
| Correções de auditoria | Não | Essencial para checar da consistência do campo. |
| Dia de entrevista | Sim | |
| Horário de entrevista | Não | Essencial para checar da consistência do campo. |
| Duração de entrevista | Não | Essencial para checar da consistência do campo. |
| Bairro de entrevista | Não | Consta bairro onde o entrevistado mora, não necessariamente onde foi feito a entrevista. |
| Setor censitário de entrevista | Não | Checar aleatoriedade da amostra |
| Geolocalização de entrevista | Não | Checar aleatoriedade da amostra |
| Peso, caso tenha sido aplicado | Não | Checar análise estatística da amostra |
| Todas as perguntas do questionário | Não | Essencial para checar consistência do campo. |
| Perguntas do questionário ausentes na base: | |
| 4 – Nome do entrevistado | Justificável – LGPD |
| 22 – Telefones de contato | Justificável – LGPD |
| 23 – Pesquisador | Validação de entrevistas e identificação de possível viés do entrevistador. |
Segundo o analista, “caso os dados listados acima não existam ou não sejam disponibilizados, a própria validade e fidedignidade da pesquisa em si ficam seriamente comprometidas, pois deixa de ser possível atestar as informações declaradas pela empresa.”
Da validação e consistência interna da base de dados da Action
Sobre os “achados” a partir da base de dados com contrariedades e inconsistências, a análise interna e robustez da base de dados da pesquisa revelou que:
1. Nove registros / linhas da base de dados estão 100% repetidos, tanto nas respostas quanto nos identificadores que deveriam ser únicos. Logo,são exatamente as mesmas informações, mesmo identificador, dia, bairro, perfil de respondente, resposta, e todas as demais variáveis.
- Esse fato revela sério comprometimento da base de dados, indicando que foram feitas menos entrevistas do que o planejado e que, para cobrir a lacuna, a ACTION preencheu a base de dados com repetição de entrevistas, caracterizando a total falta de confiança nos resultados publicados e, inclusive, na própria validade da execução das demais entrevistas, uma vez que fica em suspeição a efetiva realização das demais.
2. Observando apenas a variável “Harvest ID”, que representa a identificação única de uma entrevista, observa-se que 13 entrevistados estão com códigos de identificação repetidos na base de dados, de maneira que, ao invés de 1.250 entrevistas distintas, conclui-se que a base de dados consta com, na verdade, 1.237 registros únicos, o que representa, a princípio, 1.237 entrevistas reais, ao invés da s1.250 entrevistas declaradas. As repetições ocorreram nos registros identificados pelos números: 4032147, 4032148, 4032149, 4033821, 4034107, 4034224, 4034354, 4034401, 4034421, 4034438, 4034440, 4034560, 4034667. A figura abaixo ilustra parte da base de dados com as entrevistas repetidas. Nota-se que, em três casos em que o ID do entrevistado é o mesmo, houve pequena alteração na pergunta sobre intenção de voto espontâneo, passando de ‘Não sabe’ para algum candidato.
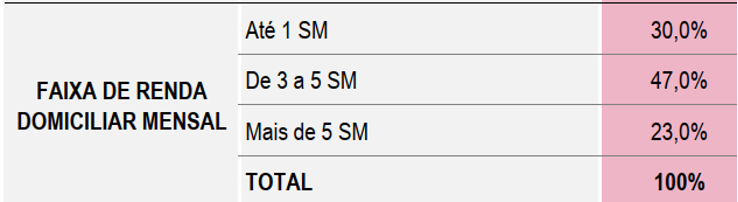
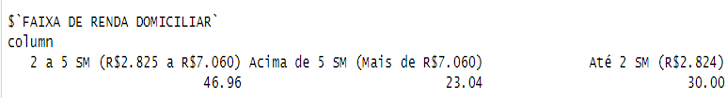
3. Os percentuais de entrevistados por faixa salarial do relatório público não coincidem com a base de dados, provavelmente por erro de digitação. Como o leitor comum não tem acesso à base de dados, esse erro compromete a interpretação da pesquisa:
- Relatório público (até 1 SM: 30%):
b. Base de dados (até 2 SM: 30%)
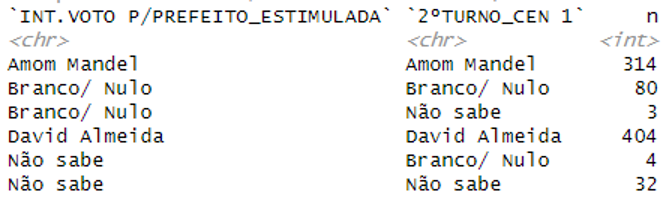
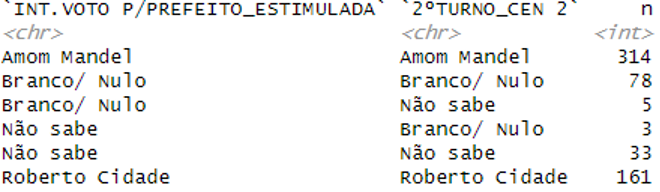
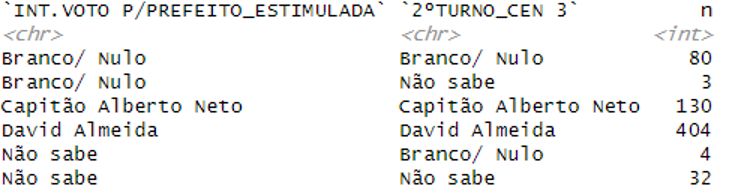
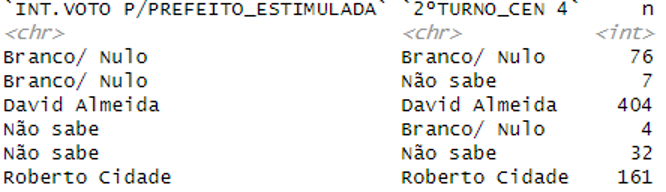
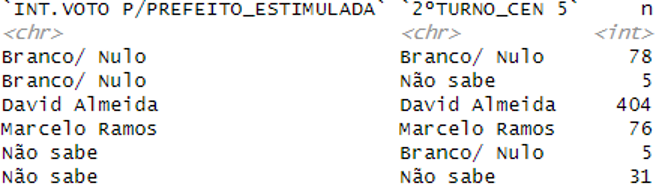
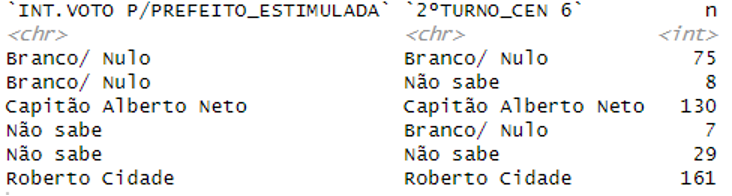
4. Cruzando a intenção de voto estimulada no primeiro turno com a intenção de voto em cenários no segundo, é possível identificar que alguns eleitores que declaram votar ‘Branco ou Nulo’ no primeiro turno, declararam ‘Não sabe’ em quem votar no segundo turno, o que é contraditório: ora, se votariam branco ou nulo no primeiro turno, e os candidatos dos cenários no segundo turno são dois dos mesmos já apresentados na pergunta anterior, não faz sentido a ocorrência de o eleitor dizer que ‘Não sabe’ em quem votar no segundo turno, o natural e esperado era que o entrevistado repetisse a resposta ‘Branco ou nulo’.
A ausência de disponibilidade dos áudios impede a auditoria e validação dessas respostas:
Do plano amostral registrado e executado
A Action afirma na metodologia registrada no TSE que “A amostra está distribuída proporcional ao tamanho (PPT)”. Ocorre que a sigla PPT significa “Probabilidade Proporcional ao Tamanho” (Bolfarine e Bussab, 2005, p. 45), ou seja, a amostra só é PPT se houver sorteio aleatório para seleção dos eleitores a serem entrevistados, e essa probabilidade de seleção é proporcional ao tamanho do Estrato Populacional ao qual o eleitor sorteado pertence.
O que se verifica, no entanto, é que a seleção dos bairros na presente pesquisa foi arbitrária (“principais bairros de Manaus definidos para essa pesquisa”), e que a seleção dos eleitores participantes da amostra foi feita ao longo de rotas (“Os pesquisadores recebem suas rotas em tabelas e mapas antes de se deslocarem aos locais de coleta”), sem definição de domicílios a serem visitados, donde se conclui que as entrevistas foram feitas ao longo das ruas.
Ora, se os bairros foram selecionados de forma intencional, não probabilisticamente, as rotas foram definidas sem sorteios, por densidade populacional, as entrevistas foram feitas ao longo das ruas, e ainda houve a necessidade de cumprir cotas, então o plano amostral é não probabilístico, o que compromete e torna viesada as estimativas feitas a partir de tal amostra, na medida em que, na escolha dos entrevistados, se inseriu viés de seleção sem o devido controle da probabilidade de seleção.
Além disso, a margem de erro reportada (2,77 pontos percentuais) não condize com a realidade, na medida em que se trata de margem de erro máxima para o caso de Amostras Aleatórias Simples (AAS), quando todos os eleitores têm exatamente a mesma probabilidade de seleção, o que só é possível fazer, na prática, mediante sorteio aleatório de cadastro completo da população-alvo (ver Bolfarine e Bussab, 2005, capítulo 3).
“Cadastro inexistente”
Como tal cadastro não existe, é praticamente impossível fazer AAS em pesquisas eleitorais, sendo necessário lançar mão de planos amostrais complexos, com cálculos de margens de erro também complexas e, usualmente, maiores do que os obtidos em AAS, como veremos adiante (ver Heeringa, West, & Berglund, 2017, para mais detalhes).
A amostragem ao longo de rotas, sem se estabelecer os domicílios a serem visitados, faz com que as probabilidades de seleção de eleitores sejam desiguais, pois pessoas que não passam pelas ruas das rotas não estejam ao alcance do entrevistador no momento da coleta de dados, ou seja, esses eleitores têm probabilidade zero de participar da amostra.
Por outro lado, eleitores que passam frequentemente pelos pontos da rota em que o entrevistador está, tem probabilidade muito maior do que os demais eleitores de participar da pesquisa.
Usualmente, alguns institutos de pesquisa tentam atenuar o viés de seleção de amostras não probabilísticas, como descrito acima, fazendo uso de quotas, como no presente caso, onde se declara, previamente, as proporções de participantes por perfil sociodemográfico.
Ocorre que o uso desse recurso, ao contrário de ‘corrigir’ a amostra, acaba por afastá-la mais ainda do conceito de amostras aleatórias, na medida em que a seleção dos entrevistados que possivelmente preencherão a quota esperada ou designada para cada entrevistador passa necessariamente pela subjetividade de escolha do entrevistado, acrescentando nova camada não probabilística na amostra. Para mais detalhes, ver Carvalho e Ferraz (2006):
A amostragem por quotas, largamente usada em pesquisas de opinião e em pesquisas de mercado, não pode ser considerada alternativa válida à amostragem probabilística. Problemas de presteza na execução e de orçamento não servem como justificativa. O problema é que não há como estimar parâmetros populacionais cientificamente, a partir de uma tal amostragem. As margens de erro declaradas, como admite o Ibope, são baseadas em fórmulas de amostragem aleatória simples, a conhecida expressão para a variância, pq/n. Mas esta variância não se aplica à amostragem por quotas ou a qualquer método de amostragem não probabilística.
Para calcular margens de erro, é necessário conhecer as probabilidades de seleção dos entrevistados. Logo, sem a informação da probabilidade de seleção, é impossível informar a verdadeira margem de erro.
Cumpre reforçar que a margem de erro informada no registro da pesquisa e no relatório de divulgação seriam as margens de erro máximas apenas no caso do uso de AAS, que é o caso delineamento amostral mais simples dentre todos (ver Bolfarine e Bussab, 2005).
Para amostras complexas, o cálculo da margem de erro é diferenciado e, na maior parte dos casos, implica em erros maiores do que aqueles obtidos em AAS. Assim, além de equivocado, a margem de erro máxima informada não pode ser usada como referência de precisão da pesquisa ora em análise.
Acrescente-se que, no caso de amostras não probabilísticas, esse cálculo é complexo e diferenciado (ver Dash, 2010, por exemplo), o que claramente não foi levado em conta na presente pesquisa.
Assim, além de o delineamento amostral aplicado não corresponder ao método registrado no TSE, as estimativas divulgadas carecem de validade estatística, na medida em que foram obtidas por meio de amostragem não probabilística e, ainda assim, tratadas como se fossem do tipo aleatória com ponderação, desrespeitando os pressupostos necessários para o cálculo das estimativas de intenção de voto desejadas na pesquisa.
Conclusão da análise da pesquisa Action
A análise da metodologia da pesquisa registrada pela ACTION no TSE sob o protocolo AM-05195/2024, do relatório de divulgação da pesquisa e da base de dados evidenciam que a pesquisa em análise:
- Não permite inferências válidas e confiáveis.
- Apresenta margens de erro declaradas que não correspondem à realidade, sendo estimativas simplistas e inadequadas.
- Apresenta falhas sérias no processo de auditoria e validação das entrevistas, na medida em que não é possível checar respostas por falta de informação, sejam elas gravações, coordenadas geográficas, ou formas de contato posterior com os entrevistados (telefones).
- Não permite identificar nem descreve o local exato dos pontos de coletas de entrevistas, o que dificulta ainda mais a possível auditoria posterior.
- Apresenta contradições e inconsistências na base de dados e no relatório de divulgação que precisam ser sanadas para elucidar qualquer dúvida sobre a validade e fidedignidade dos resultados apresentados.
- Apresenta indícios de alteração da base de dados original de forma intencional para alcançar as 1.250 entrevistas registrada, ao replicar 13 entrevistas, de maneira que, na realidade, foram feitas 1.237 entrevistas.
Dessa forma, os resultados apresentados não podem ser utilizados como estimativas válidas para as intenções de voto em Manaus, conclui a análise.
O que diz a análise da pesquisa divulgada pelo Ipen
Sobre a 2ª pesquisa eleitoral realizado pela empresa Instituto de Pesquisa do Norte Ltda. (Ipen) este ano, registrada no TSE sob o número AM-08938/2024 com as seguintes informações:
- Campo: 1.000 entrevistas de 10 a 19 de junho de 2024.
- População-alvo: não consta no registro no TSE a definição clara e inequívoca da população-alvo da pesquisa, embora conste no relatório de divulgação da pesquisa a informação de que o público-alvo são os eleitores da cidade de Manaus. É importante definir claramente qual a população-alvo no registro do TSE, para que se saiba se a escolha dos bairros cobertos na amostra reflete adequadamente ou não o objetivo da pesquisa.
Sobre a base de dados da pesquisa Ipen e os dados faltantes
A base de dados da pesquisa, em formato Microsoft Excel, contém 1.000 registros e 37 variáveis, a saber:”SbjNum”, “PRACA”, “PF1”, “PF2”, “P1”, “PF3”, “P2_FX”, “P2a”, “P3”, “perfil”, “peso”, “P4”, “P5”, “P6”, “P7”, “P8”, “P9”, “P10_O1”, “P10_O2”, “P10_O3”, “P11”, “P12”, “P13”, “P14”, “P15”, “P16”, “P17”, “P17_OTHER”, “P18”, “P19”, “P19_OTHER”, “ENTREVISTADO”, “TELEFONE”, “ENDERECO”, “PESQUISADOR_COD”, “CODIGO_BAIRRO”, “ZONA”.
As informações listadas abaixo estão ausente na base de dados disponibilizadas. Sua inclusão é essencial e indispensável para a análise, validação, auditoria e consequente credibilidade dos resultados obtidos e apresentados no relatório final da pesquisa:
- Coordenadas geográficas (geolocalização, georreferenciamento) do local onde cada entrevista foi realizada.
- Dia e horário de realização da entrevista.
- Link de acesso aos áudios das entrevistas para fins de auditoria.
- Identificação das entrevistas auditadas (‘…coordenadores terão a responsabilidade de revisar 20% dos questionários preenchidos no campo’).
- Duração da entrevista.
- Informação de quais entrevistas foram auditadas. O registro da pesquisa no TSE prevê que 30% das entrevistas feitas por cada um dos entrevistadores seriam auditadas. Essa identificação não consta na base de dados.
- Informação das correções feitas nas auditorias. Além de informar quais entrevistas foram auditadas ou checadas, é necessário informar o resultado da checagem, a fim de se verificar a qualidade das entrevistas e das auditorias.
Da validação e consistência interna da base de dados da Pesquisa Ipen
Sobre os “achados a partir da base de dados com contrariedades e inconsistências”, a análise feita é a seguinte:Os resultados obtidos a partir da base de dados só coincidem com os resultados divulgados em relatório se as estatísticas forem calculadas considerando a variável ‘peso’.
Ocorre que em nenhum momento no registro da pesquisa é informado que se fará uso de ponderação para o cálculo dos resultados. Essa informação também não consta no relatório de divulgação da pesquisa.
Ora, conhecer o critério de ponderação é essencial para a credibilidade da pesquisa, e ocultar que foi usado ponderação, bem como ocultar qual o método de cálculo dos pesos, compromete significativamente a confiabilidade nos resultados divulgados, pois se abre margem para grande subjetividade e falta de clareza nos procedimentos metodológicos adotados.
- A variável ‘peso’ assume valores entre 0,2607 e 6,3252, com média 0,9995 e desvio padrão 0,4380, significando que há variabilidade não desprezível na ponderação atribuída a cada respondente.
O uso das quotas, embora não probabilístico, deveria permitir o cálculo das estimativas sem ponderação. O fato de o peso amostral ser tão variável indica que o uso de quotas não foi eficiente. Isto reforça a necessidade de explicação e detalhamento do método utilizado no processo de ponderação da amostra.
| Estatísticas da variável ‘peso’ | |
| Mínimo | 0,2607 |
| 1o quartil | 0,7442 |
| Mediana | 0,8674 |
| Média | 0,9995 |
| 3o quartil | 1,1390 |
| Máximo | 6,3252 |
| Desvio padrão | 0,4382 |
| Coeficiente de variação | 43,82% |
- A quantidade de entrevistas planejada foi diferente da quantidade de entrevistas realizada nos bairros Alvorada, Dom Pedro I, Japiim e São Francisco:
| BAIRRO | AMOSTRA PLANEJADA | AMOSTRA REALIZADA | DIFERENÇA |
| ALVORADA | 34 | 33 | 1 |
| DOM PEDRO I | 11 | 12 | -1 |
| PLANALTO | 10 | 10 | 0 |
| REDENÇÃO | 19 | 19 | 0 |
| ALEIXO | 18 | 18 | 0 |
| FLORES | 39 | 39 | 0 |
| PARQUE 1O DE NOVEMBRO | 29 | 29 | 0 |
| ARMANDO MENDES | 14 | 14 | 0 |
| COLÔNIA ANTÔNIO ALEIXO | 10 | 10 | 0 |
| COROADO | 27 | 27 | 0 |
| GILBERTO MESTRINHO | 34 | 34 | 0 |
| JORGE TEIXEIRA | 68 | 68 | 0 |
| MAUAZINHO | 14 | 14 | 0 |
| SÃO JOSÉ OPERÁRIO | 33 | 33 | 0 |
| TANCREDO NEVES | 25 | 25 | 0 |
| ZUMBI DOS PALMARES | 18 | 18 | 0 |
| CIDADE DE DEUS | 43 | 43 | 0 |
| CIDADE NOVA | 65 | 65 | 0 |
| COLÔNIA TERRA NOVA | 37 | 37 | 0 |
| LAGO AZUL | 32 | 32 | 0 |
| MONTE DAS OLIVEIRAS | 28 | 28 | 0 |
| NOVA CIDADE | 38 | 38 | 0 |
| NOVO ALEIXO | 53 | 53 | 0 |
| SANTA ETELVINA | 21 | 21 | 0 |
| COMPENSA | 41 | 41 | 0 |
| LÍRIO DO VALE | 13 | 13 | 0 |
| NOVA ESPERANÇA | 11 | 11 | 0 |
| PONTA NEGRA | 11 | 11 | 0 |
| SANTO ANTÔNIO | 10 | 10 | 0 |
| SÃO JORGE | 12 | 12 | 0 |
| TARUMÃ | 34 | 34 | 0 |
| TARUMÃ-AÇU | 16 | 16 | 0 |
| CACHOEIRINHA | 12 | 12 | 0 |
| CENTRO | 21 | 21 | 0 |
| CRESPO | 11 | 11 | 0 |
| JAPIIM | 42 | 44 | -2 |
| PETROPÓLIS | 33 | 33 | 0 |
| SÃO FRANCISCO | 13 | 11 | 2 |
- Constam na base 18 códigos de entrevistadores, embora o registro no TSE mencione que a equipe contaria com 15 entrevistadores.
- O resultado apresentado no relatório da pergunta sobre ‘Rejeição’ dos candidatos não corresponde aos números obtidos a partir da base de dados, seja utilizando a variável ‘peso’ ou não.
Na base de dados, a pergunta ‘P10. (ESTIMULADA/Múltipla até 3/CARTÃO 1) Se a eleição fosse hoje, em qual desses candidatos você não votaria de jeito nenhum?’ (rejeição) apresenta três subvariáveis, P10_1, P10_2 e P10_3. Deduz-se, a partir do enunciado da pergunta no questionário, que se trata de três opções de rejeição.
Apesar dessa dedução, os resultados apresentados no relatório não coincidem com qualquer álgebra a partir da base de dados, sendo necessário que a IPEN esclareça qual foi o processo adotado para o cálculo da rejeição, sob pena de deixar seus resultados em suspeição. A transparência é a melhor prova de qualidade dos dados.
Resultado no relatório divulgado:
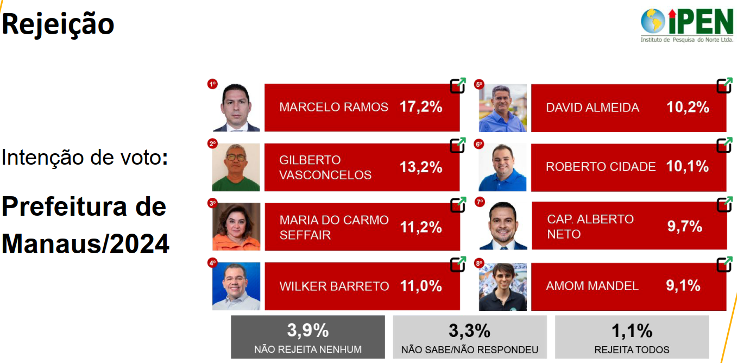
Resultado obtido a partir da base de dados e considerando a variável de ponderação:
| P10. (ESTIMULADA/Múltipla até 3/CARTÃO 1) Se a eleição fosse hoje, em qual desses candidatos você não votaria de jeito nenhum? | P10_01 (%) | P10_02 (%) | P10_03 (%) |
| 1. David Almeida | 15,50 | 3,18 | 0,62 |
| 2. Amon Mandel | 9,55 | 5,27 | 2,51 |
| 3. Cap. Alberto Neto | 9,84 | 4,85 | 3,73 |
| 4.Marcelo Ramos | 19,30 | 9,02 | 4,22 |
| 5. Roberto Cidade | 6,08 | 6,79 | 6,22 |
| 6. Maria do Carmo Seffair | 7,90 | 7,99 | 5,35 |
| 7. Wilker Barreto | 6,58 | 8,44 | 5,72 |
| 8.Gilberto Vasconcelos | 9,55 | 8,10 | 7,40 |
| 9. Rejeita todos | 2,12 | 46,30 | 64,20 |
| 10. Não Rejeita Nenhum | 7,38 | ||
| 11. Não sabe/não respondeu | 6,11 |
O resultado apresentado no relatório de divulgação para a pergunta ‘P16. Na sua opinião o apoio do ex-presidente Bolsonaro, a um candidato, aumentaria, diminuiria ou não influenciaria sua vontade de votar no candidato?’ difere completamente do resultado obtido a partir da base de dados, fazendo uso ou não da variável de ponderação:
Resultado divulgado:
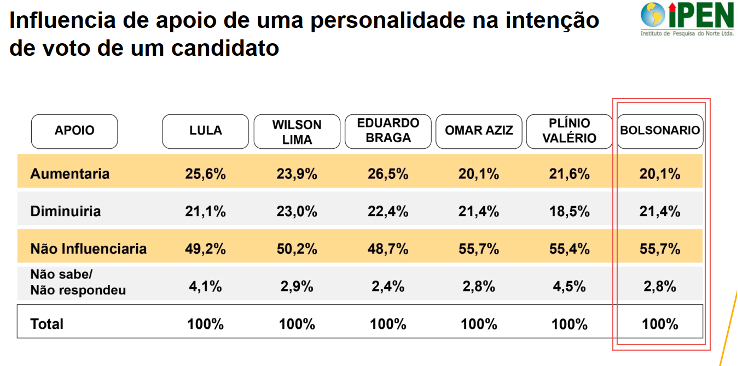
Resultado obtido a partir da base de dados e usando a ponderação:
| P16. Na sua opinião o apoio do ex-presidente Bolsonaro, a um candidato, aumentaria, diminuiria ou não influenciaria sua vontade de votar no candidato? | |
| Aumentaria | 41,00% |
| Diminuiria | 25,40% |
| Não influenciaria | 32,00% |
| Não sabe / não respondeu | 1,52% |
Cruzando a intenção de voto estimulada no primeiro turno com a intenção de voto diante de cenários com apenas dois candidatos, é possível identificar as seguintes incongruências de respostas que deveriam ser submetidas a auditoria para validação da resposta ou correção de erro de marcação:
Contradições no cenário de DAVID ALMEIDA versus AMON MANDEL:
- 28 marcações de que o eleitor votaria em DAVID ALMEIDA no primeiro turno, mas o mesmo eleitor votaria em AMON MANDEL.
- 10 marcações de que o eleitor votaria em AMON MANDEL no primeiro turno, mas o mesmo eleitor votaria em DAVID ALMEIDA no segundo turno.
| Intenção de voto estimulado no 1o turno | Intenção de voto supondo apenas 2 candidatos | Ocorrências na base |
| 1. David Almeida | 1. David Almeida | 318 |
| 1. David Almeida | 2. Amon Mandel | 28 |
| 1. David Almeida | 9. NS/NR | 3 |
| 1. David Almeida | 10. Branco/Nulo | 0 |
| 2. Amon Mandel | 1. David Almeida | 10 |
| 2. Amon Mandel | 2. Amon Mandel | 239 |
| 2. Amon Mandel | 9. NS/NR | 0 |
| 2. Amon Mandel | 10. Branco/Nulo | 1 |
Contradições no cenário de DAVID ALMEIDA versus CAP. ALBERTO NETO
- 33 marcações de que o eleitor votaria em DAVID ALMEIDA no primeiro turno, mas o mesmo eleitor votaria em CAP. ALBERTO NETO.
- 1 marcação de que o eleitor votaria em CAP. ALBERTO NETO no primeiro turno, mas o mesmo eleitor votaria em DAVID ALMEIDA no segundo turno.
| Intenção de voto estimulado no 1o turno | Intenção de voto supondo apenas 2 candidatos | Ocorrências na base |
| 1. David Almeida | 1. David Almeida | 313 |
| 1. David Almeida | 3. Cap. Alberto Neto | 33 |
| 1. David Almeida | 9. NS/NR | 2 |
| 1. David Almeida | 10. Branco/Nulo | 1 |
| 3. Cap. Alberto Neto | 1. David Almeida | 1 |
| 3. Cap. Alberto Neto | 3. Cap. Alberto Neto | 4 |
| 3. Cap. Alberto Neto | 9. NS/NR | 0 |
| 3. Cap. Alberto Neto | 10. Branco/Nulo | 67 |
Contradições no cenário DAVID ALMEIDA versus MARCELO RAMOS:
- 25 marcações de que o eleitor votaria em DAVID ALMEIDA no primeiro turno, mas o mesmo eleitor votaria em MARCELO RAMOS.
- 10 marcações de que o eleitor votaria em MARCELO RAMOS no primeiro turno, mas o mesmo eleitor votaria em DAVID ALMEIDA no segundo turno.
| Intenção de voto estimulado no 1o turno | Intenção de voto supondo apenas 2 candidatos | Ocorrências na base |
| 1. David Almeida | 1. David Almeida | 322 |
| 1. David Almeida | 3. Marcelo Ramos | 25 |
| 1. David Almeida | 9. NS/NR | 2 |
| 1. David Almeida | 10. Branco/Nulo | 0 |
| 3. Marcelo Ramos | 1. David Almeida | 10 |
| 3. Marcelo Ramos | 3. Marcelo Ramos | 41 |
| 3. Marcelo Ramos | 9. NS/NR | 0 |
| 3. Marcelo Ramos | 10. Branco/Nulo | 1 |
Contradições no cenário DAVID ALMEIDA versus ROBERTO CIDADE:
- 31 marcações de que o eleitor votaria em DAVID ALMEIDA no primeiro turno, mas o mesmo eleitor votaria em ROBERTO CIDADE.
- 7 marcações de que o eleitor votaria em ROBERTO CIDADE no primeiro turno, mas o mesmo eleitor votaria em DAVID ALMEIDA no segundo turno.
| Intenção de voto estimulado no 1o turno | Intenção de voto supondo apenas 2 candidatos | Ocorrências na base |
| 1. David Almeida | 1. David Almeida | 318 |
| 1. David Almeida | 5. Roberto Cidade | 31 |
| 1. David Almeida | 9. NS/NR | 0 |
| 1. David Almeida | 10. Branco/Nulo | 0 |
| 5. Roberto Cidade | 1. David Almeida | 7 |
| 5. Roberto Cidade | 5. Roberto Cidade | 77 |
| 5. Roberto Cidade | 9. NS/NR | 1 |
| 5. Roberto Cidade | 10. Branco/Nulo | 2 |
Sobre o Plano Amostral registrado e executado
A Ipen é contraditória e incoerente no registro no TSE do plano amostral delineado pois, ao mesmo tempo em que argumenta que sua amostra será presencial em ponto de fluxo, e que fará uso de quotas para sexo, idade e escolaridade, informa margens de erro e níveis de confiança correspondentes a Amostragem Aleatória Simples (AAS) e calculadas como se esse fosse o delineamento amostral aplicado.
Na AAS todos os eleitores têm exatamente a mesma probabilidade de seleção, o que só é possível fazer, na prática, mediante sorteio aleatório de cadastro completo da população-alvo (ver Bolfarine e Bussab, 2005, capítulo 3).
Como tal cadastro não existe, é praticamente impossível fazer AAS em pesquisas eleitorais, sendo necessário lançar mão de planos amostrais complexos, com cálculos de margens de erro também complexas e, usualmente, maiores do que os obtidos em AAS, como veremos adiante (ver Heeringa, West, & Berglund, 2017, para mais detalhes).
Probabilidades de seleção desiguais
A amostragem por ponto de fluxo faz com que as probabilidades de seleção sejam desiguais, pois pessoas que não passam pelos pontos de fluxo selecionados para coleta de dados tem probabilidade zero de participar da amostra, e eleitores que passam frequentemente pelos pontos de fluxo tem probabilidade muito maior do que os demais de participar da pesquisa.
Acrescente-se que pesquisas em pontos de fluxo estão sujeitas à subjetividade de seleção dos entrevistadores que, naturalmente, procurarão por pessoas que acreditem estarem mais propensas a responder, de maneira que a chance de escolha de um ou outro potencial entrevistado é diferente e modulada por essa subjetividade.
Além disso, a subjetividade da escolha é diferente entre cada um dos entrevistadores recrutados para realizar o campo da pesquisa. Logo, além das diferenças intrínsecas de propensão de escolha do entrevistador, a chance de escolha para uma pessoa participar da pesquisa é diferenciada também entre entrevistadores, o que compromete e diferencia ainda mais a escolha do entrevistado.
Subjetividade de escolha dos bairros e dos pontos de fluxo
No presente caso também há a subjetividade de escolha dos bairros e dos pontos de fluxo onde as entrevistas foram realizadas. Não há nenhuma justificativa técnica para a especificação dos bairros, bem como não é possível saber, com base nos dados divulgados, o local dos pontos de fluxo selecionados, de maneira que é impossível validar ou auditar a correspondência entre o local de entrevista declarado e o local realizado.
Usualmente alguns institutos de pesquisa tentam atenuar o viés de seleção de amostras não probabilísticas, como descrito acima, fazendo uso de quotas, como no presente caso, onde se declara, previamente, as proporções de participantes por perfil sociodemográfico.
Ocorre que o uso desse recurso, ao contrário de ‘corrigir’ a amostra, acaba por afastá-la mais ainda do conceito de amostras aleatórias, na medida em que a seleção dos entrevistados que possivelmente preencherão a quota esperada ou designada para cada entrevistador passa necessariamente pela subjetividade de escolha do entrevistado, acrescentando nova camada não probabilística na amostra. Para mais detalhes, ver Carvalho e Ferraz (2006):
A amostragem por quotas, largamente usada em pesquisas de opinião e em pesquisas de mercado, não pode ser considerada alternativa válida à amostragem probabilística. Problemas de presteza na execução e de orçamento não servem como justificativa. O problema é que não há como estimar parâmetros populacionais cientificamente, a partir de uma tal amostragem. As margens de erro declaradas, como admite o Ibope, são baseadas em fórmulas de amostragem aleatória simples, a conhecida expressão para a variância, pq/n. Mas esta variância não se aplica à amostragem por quotas ou a qualquer método de amostragem não probabilística.
Para calcular margens de erro, é necessário conhecer as probabilidades de seleção dos entrevistados. Logo, sem a informação da probabilidade de seleção, é impossível informar a verdadeira margem de erro.
A margem de erro de 3,09% com nível de confiança de 95% informada no registro da pesquisa e no relatório de divulgação seriam as margens de erro máximas apenas no caso do uso de AAS, que é o caso delineamento amostral mais simples dentre todos (ver Bolfarine e Bussab, 2005).
Para amostras complexas, o cálculo da margem de erro é diferenciado e, na maior parte dos casos, implica em erros maiores do que aqueles obtidos em AAS. Assim, além de equivocado, a margem de erro máxima informada não pode ser usada como referência de precisão da pesquisa ora em análise. Cumpre ressaltar que, no caso de amostras não probabilísticas, esse cálculo é complexo e diferenciado, feito idealmente por meio de modelos estatísticos (ver Dash, 2010, por exemplo), o que claramente não foi o caso na presente pesquisa.
Assim, além de o delineamento amostral aplicado não corresponder ao método registrado no TSE, as estimativas divulgadas carecem de validade estatística, na medida em que foram obtidas por meio de amostragem não probabilística e, ainda assim, tratadas como se fossem do tipo aleatória com ponderação, desrespeitando os pressupostos necessários para o cálculo das estimativas de intenção de voto desejadas na pesquisa.
Conclusão da análise da pesquisa Action
A análise da metodologia da pesquisa registrada no TSE sob o protocolo AM-08938/2024, do relatório de divulgação da pesquisa e da base de dados evidenciam que a pesquisa em análise:
- Não permite inferências válidas e confiáveis.
- Apresenta margens de erro declaradas que não correspondem à realidade, sendo estimativas simplistas e inadequadas.
- Apresenta falhas sérias no processo de auditoria e validação das entrevistas, na medida em que não é possível checar respostas por falta de informação, sejam elas gravações, coordenadas geográficas, ou formas de contato posterior com os entrevistados (telefones).
- Não permite identificar nem descreve o local exato dos pontos de coletas de entrevistas, o que dificulta ainda mais a possível auditoria posterior.
- Apresenta contradições e inconsistências na base de dados e no relatório de divulgação que precisam ser sanadas para elucidar qualquer dúvida sobre a validade e fidedignidade dos resultados apresentados.
Dessa forma, os resultados apresentados não podem ser utilizados como estimativas válidas para as intenções de votos em Manaus.
Referências bibliográficas utilizadas para as análses
BOLFARINE, Heleno; DE OLIVEIRA BUSSAB, Wilton. Elementos de amostragem. Editora Blucher, 2005.
DASH, Neale Ahmed El. Avaliação metodológica das pesquisas eleitorais brasileiras. 2010. Tese (Doutorado em Estatística) – Instituto de Matemática e Estatística, Universidade de São Paulo, São Paulo, 2010. doi:10.11606/T.45.2010.tde-20220712-125043.
DE CARVALHO, José Ferreira; FERRAZ, Cristiano. A Falsidade das Margens de Erro de Pesquisas Eleitorais Baseadas em Amostragem por Quotas. 2006. Disponível em https://egov.ufsc.br/portal/sites/default/files/anexos/32729-40324-1-PB.pdf.
HEERINGA, Steven G., BRADY T. West, and Patricia A. Berglund. Applied survey data analysis. chapman and hall/CRC, 2017.





